PDF处理之殇
做社科的有时候避免不了要发放问卷,有时候还要做纸质版,处理格式问题的时候那是一弄一个不吱声。PDF的处理逻辑,就是把文字盖在原文上面做一个覆层,本身没有什么排版属性。
当然,如果你用AI工具,也可以做排版,但效率很低,一份科研数据可能要几千上万形态各异的pdf内容,根本做不过来。
文本抽取的问题
抽文本的程序认的是字符位置,不认目录。点线、页眉、页脚都算正文。文件一长,页码、空行全都是乱的。
扫描件走普通文字识别,字也许能搞定,但是图表就别想了。数字、公式什么的,一会歪这去一会缺东西。识别结果往往也没有什么有价值的、方便二次加工的信息。
MinerU 搞定了啥
MinerU 是 OpenDataLab 放在 GitHub 上的开源项目,仓库名 opendatalab/MinerU。它把 PDF、扫描件和 Office 文档拆成 Markdown 或 JSON,交给后面的检索或模型,这个做法和JINA AI的早期思路有点类似。[1]
解析分四档。Flash 做快读和索引,Basic 做文字识别和按模型解析,Standard 和 Advanced 留给更挤的版面。PDF 和图片可以走四档。Word、表格、演示文稿这类走本地的 Flash。纯文本直接读。[1]
同一份结果可以再导出 Markdown、HTML、LaTeX 等。每个入口只开放其中一部分,不是装上就能出全部格式。文件不会自动传到官方服务器,要远程解析得自己打开。[1]
这个就牛逼了,2026 年 9 月 23 日,公开仓库斩获8k+stars。仓库首页还链了三篇技术报告,感兴趣的可以读一读。[2][3][4]
实测效果
这个项目目前在官方网站、Hugging Face,魔塔社区都上架了镜像,直接就能测试。[5]
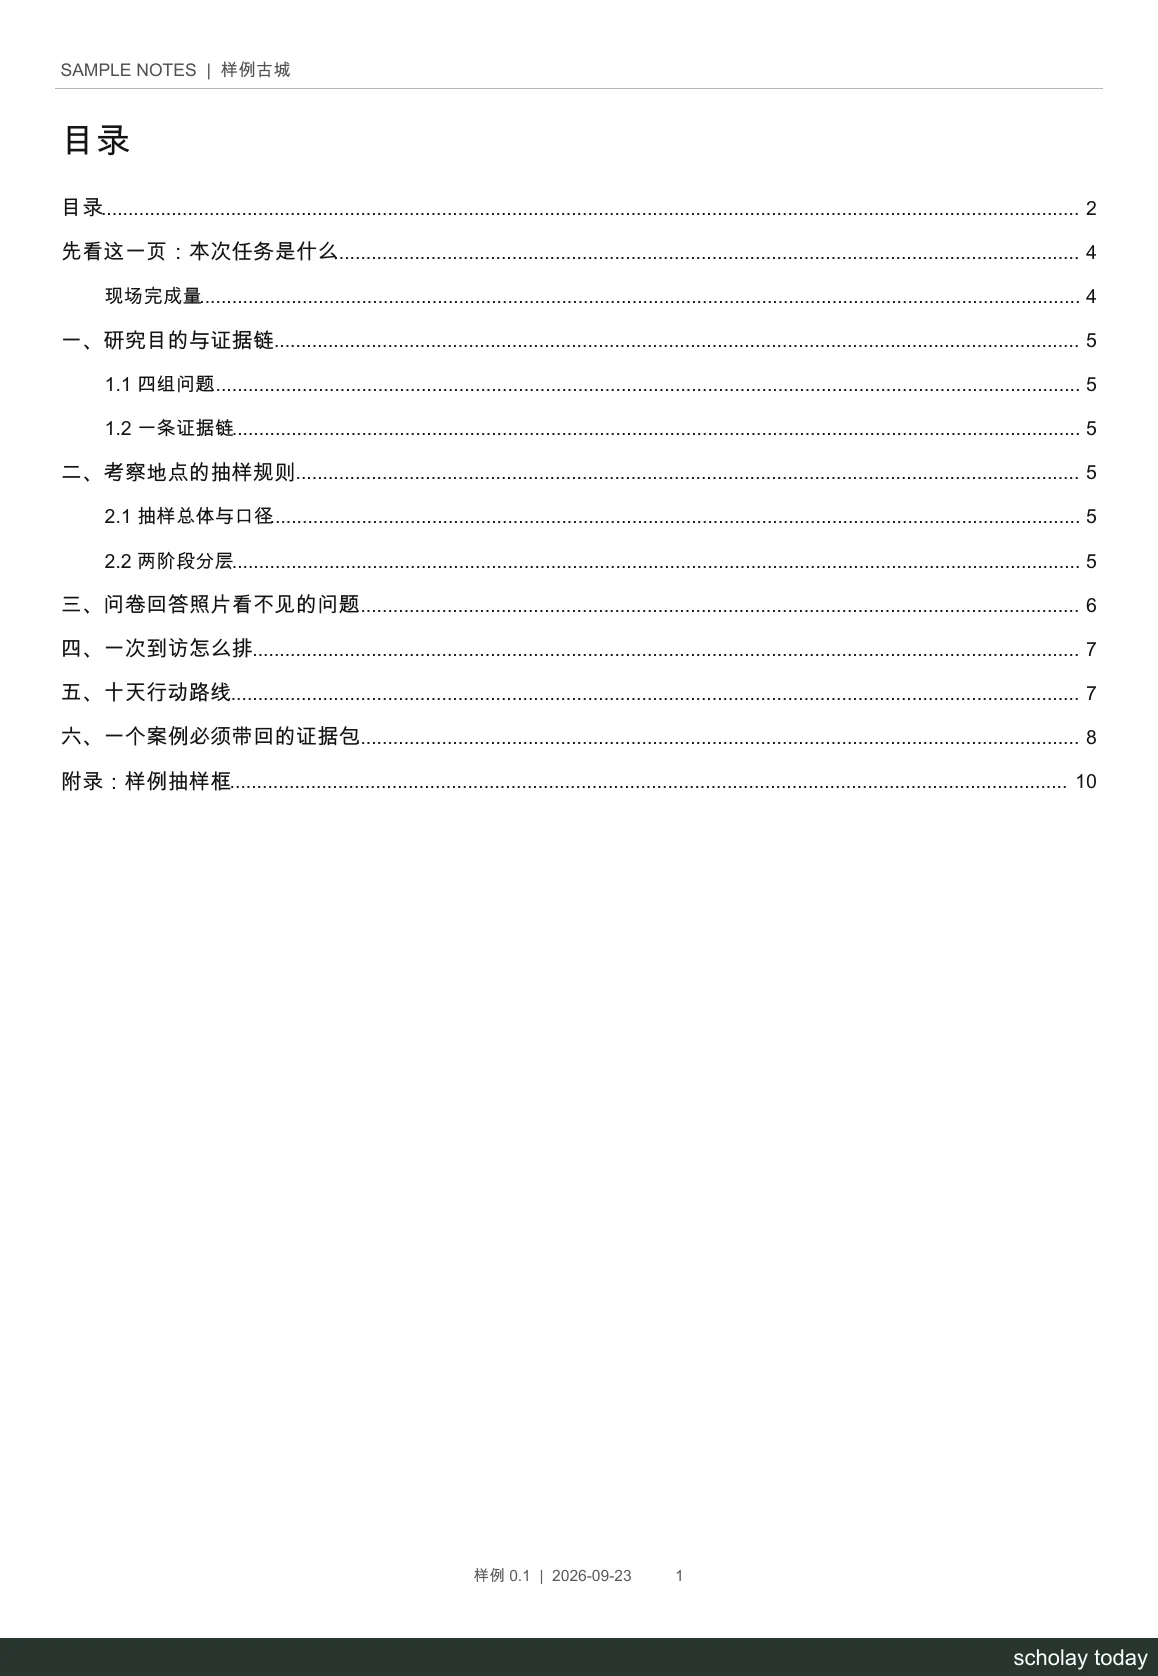
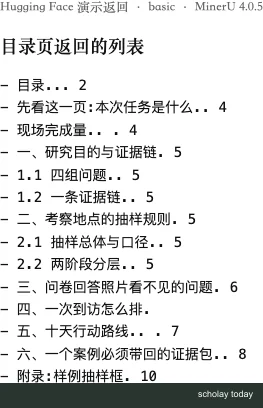
这里搞了一篇建筑学的文档样例,看看它对格式的处理到底如何。
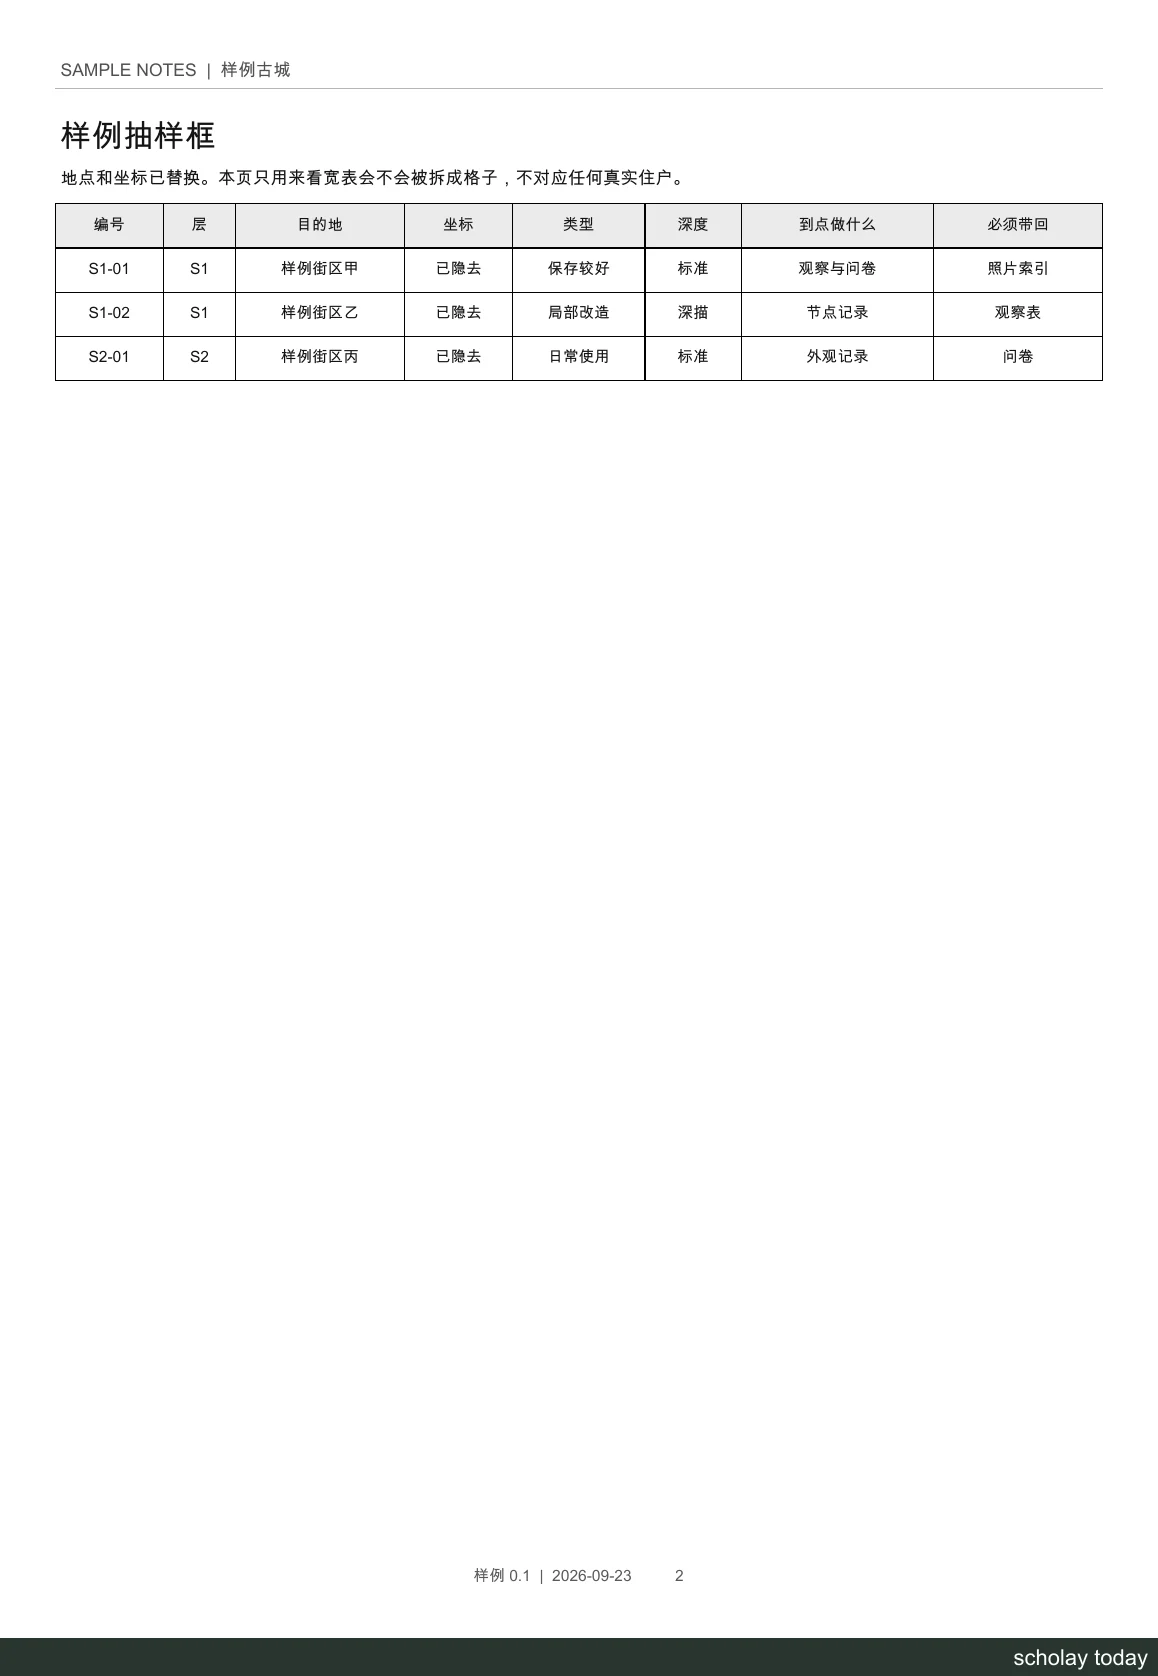
这个效果就很nice,八列三行都在,格子也没有串行。
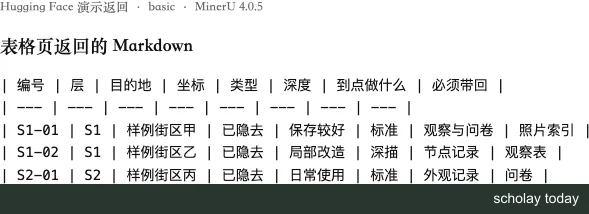
markdown原生语法处理也是手拿把掐。
什么时候用它
我一般开组会的时候,汇总多篇PDF的时候,制作ppt的话,比较讨厌直接截图,不方便做数据可视化。直接抽取文字,又有非常大的排版压力。MinerU救我狗命,谢谢。
不过也不能完全依赖,我看了,有的时候返回体也会出现闭合问题,或者缺字,但总体来说,作为AI agent预料投喂的预处理,这个东西,兄弟们,神了。
互联网的本心是免费与共享,愿自由的精神伴你每天,这里是学术海的开源分享,下期再见!
参考文献
-
[1] OpenDataLab. MinerU[EB/OL]. (2026-09-22)[2026-09-23]. https://github.com/opendatalab/MinerU.
-
[2] MinerU Technical Report[EB/OL]. https://arxiv.org/abs/2409.18839.
-
[3] MinerU2.5 Technical Report[EB/OL]. https://arxiv.org/abs/2509.22186.
-
[4] MinerU2.5 Pro Technical Report[EB/OL]. https://arxiv.org/abs/2604.04771.
-
[5] OpenDataLab. MinerU Hugging Face demo[EB/OL]. (2026-09-23)[2026-09-23]. https://huggingface.co/spaces/opendatalab/MinerU.