学术资源 / 固定快照
Datasets 5.1 新增生物序列与结构格式
Hugging Face Datasets 是 Hugging Face 维护的 Python 数据集加载与处理库,GitHub 仓库为 huggingface/datasets,以 Apache-2.0 许可证开源。2026 年 10 月 5 日(UTC)发布的 5.1.0 版新增 FASTA、FASTQ、GenBank、PDB 和 mmCIF 五种生物数据格式的加载支持,以及 BioSequence、BioStructure 两种特征类型。本文为资料核验,未安装实测。 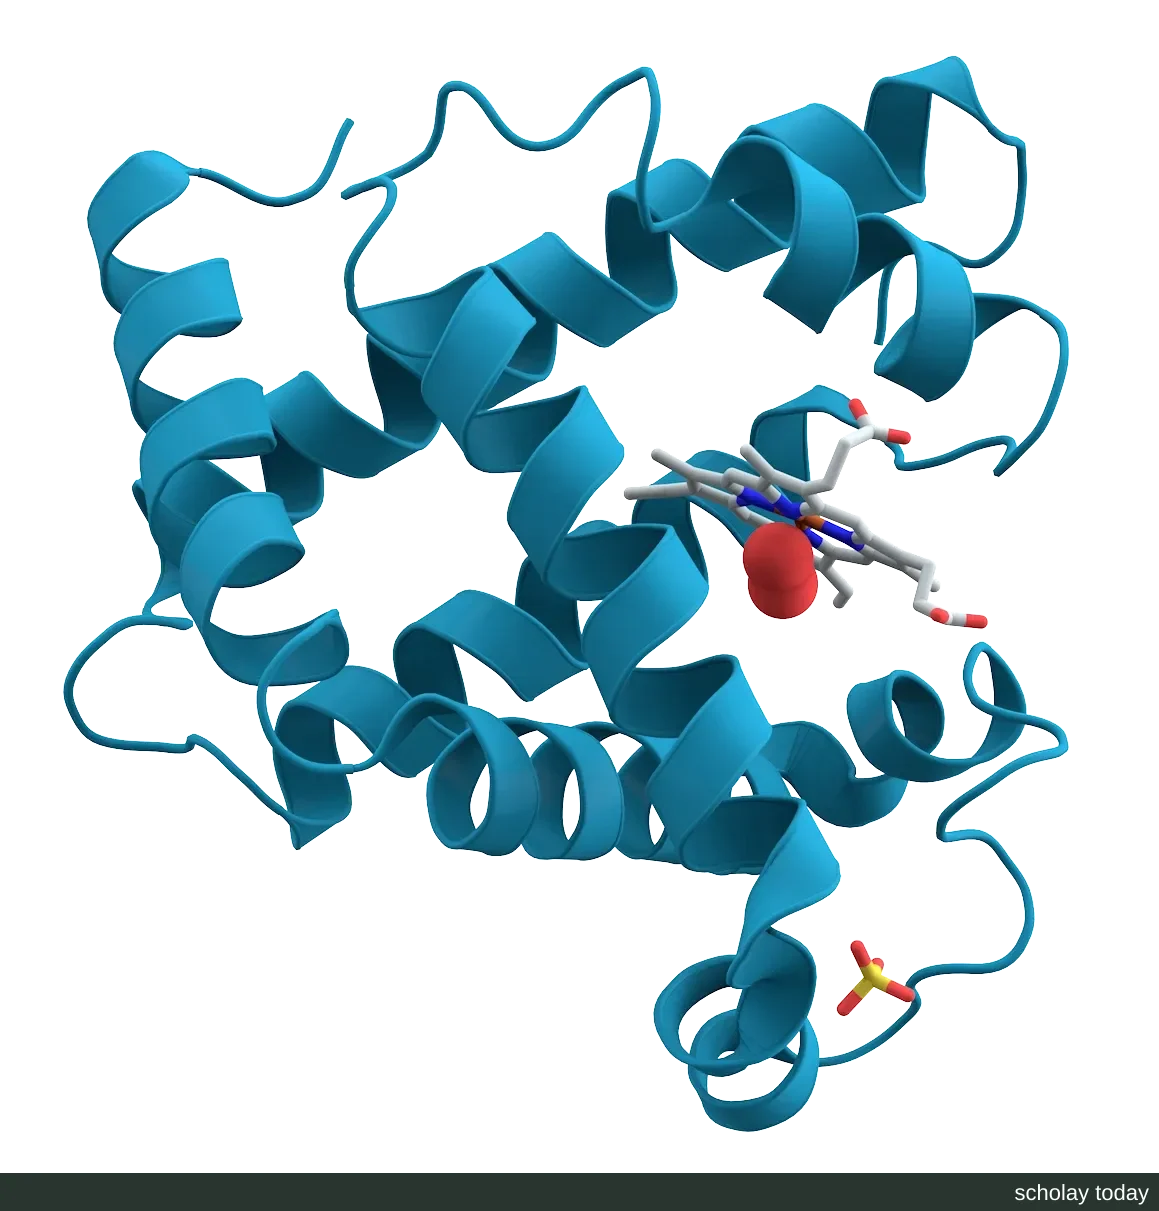 肌红蛋白三维结构的飘带图,作者依据蛋白质数据库(PDB)条目绘制;PDB 与 mmCIF 正是 5.1.0 新增支持的结构文件格式。图片:AzaToth,来源 Wikimedia Commons(File:Myoglobin.png),公有领域。 ### 项目定位、许可证与安装 Datasets 的核心入口是 `load_dataset()`:从 Hugging Face Hub 上的数据集仓库或本地文件读入数据,得到以 Apache Arrow 为存储后端的数据集对象,再用 `map()`、`filter()`、`shuffle()` 等方法做预处理;放不进内存的大数据可以用 `IterableDataset` 流式读取,处理结果能用 `push_to_hub()` 上传回 Hub。可选依赖里列有 PyTorch、TensorFlow 和 JAX,方便把数据接进这些框架训练。PyPI 分类标注的目标用户包括开发者、教育和科研人员。 截至 2026 年 10 月 20 日核验,仓库根目录 LICENSE 为 Apache License 2.0 全文,5.1.0 标签下 `setup.py` 的 license 字段写作“Apache 2.0”,分类标签为 OSI 认可的 Apache Software License。这份许可只管库的代码。通过 `load_dataset()` 取得的数据集各有来源和使用条款,Apache-2.0 不会延伸到数据本身,引用或再分发前仍要逐个查看数据集说明。 5.1.0 要求 Python 3.10 及以上,包名为 `datasets`,基础安装用 `pip install datasets`。生物格式的特征解码依赖 Biopython,它被声明为 `bio` 可选依赖(`biopython>=1.80`),可用 `pip install "datasets[bio]"` 一并安装。以上命令依据 5.1.0 标签下的 `setup.py` 整理,本文没有在本机执行。 ### 5.1.0 的更新内容 GitHub Releases 显示,5.1.0 由维护者 lhoestq 于 2026 年 10 月 5 日 15:39(UTC)发布,上一版本是 5.0.1,截至核验日仍是最新版本。更新说明把新增的数据格式分为三类:Harbor,用于强化学习环境的基准数据;Vortex,一种高性能列式文件格式;生物格式,用于存放 DNA 序列、蛋白质链和三维分子结构。数据集功能方面,可迭代数据集的 `split_dataset_by_node` 增加了 `strategy` 参数,`IterableDataset.push_to_hub` 允许设置比数据集现有分片更多的 `num_shards`。 生物格式部分由贡献者 behroozazarkhalili 的一组 PR 构成。依照已合并 PR 的说明,FASTA 文件按“一条序列记录一行”读入,用基于 Heng Li 的 readfq 改写的纯 Python 解析器得到 `id`、`description`、`sequence` 三列,不需要额外依赖,支持流式读取和 gzip、bzip2、xz 压缩文件;每行另有一个 `record` 列,原样保存这条记录的字节。FASTQ 加载器与 FASTA 的实现高度相近,GenBank 带注释的序列记录也归入同一种序列类型。PDB 和 mmCIF 则仿照图像文件夹的加载方式,一个结构文件对应一行,`structure` 列保存整份文件。 两种新特征类型负责把原始字节变成科研人员熟悉的对象。`BioSequence` 服务 FASTA、FASTQ 和 GenBank,解码结果是 Biopython 的 `SeqRecord`;`BioStructure` 服务 PDB 和 mmCIF,解码结果是 `Bio.PDB` 的 `Structure`。它们沿用 `Audio`、`Image`、`Pdf` 等已有类型的做法:存储为“字节 + 路径”结构,设置 `decode=False` 时直接返回原始字节,未安装 Biopython 时解码会报 `ImportError`。PR 说明拆成两种类型是照着 Biopython 自身 `Bio.SeqIO` 与 `Bio.PDB` 的分界,这样调用者拿到的对象类型是确定的。 其余改动以修复为主,其中两项与读取外部数据的安全有关:修复了压缩包路径检查可被同级目录绕过的问题,并禁止 HDF5 文件中的外部链接。5.1.0 的 `setup.py` 要求 pyarrow 不低于 24.0.0(注释写明为 Vortex 所需)、huggingface_hub 不低于 1.31.0,fsspec 上限放宽到 2026.7.0。
- 收录日期
- 2026-10-20
- 类别
- 数据与评测
- 状态
- 资料核验,未安装实测(2026-10-20 核验)
为何收录
对用 Python 训练序列或结构模型的研究者来说,5.1.0 省掉的是数据进入训练流程前的一段自写脚本。此前在 Datasets 里使用这些格式,需要先自己解析 FASTA,整理成表格或 JSON 再读入;结构数据还要另外接入 PDB、mmCIF 解析工具。现在这些文件可以像文本和图像一样用 load_dataset() 读入,序列直接成为可筛选、可打乱、可划分的列,结构文件以行为单位进入同一套 map()、filter()、训练集与测试集划分和分片流程。需要原生对象时再解码成 Biopython 的 SeqRecord 或 Structure,继续用 Biopython 的工具处理。
适合的研究场景
几类工作最可能受益。一是蛋白质语言模型、基因组模型的训练和微调:大型 FASTA 文件可以压缩存放、流式读取,不必先全部展开到内存。二是按结构文件组织的分类或回归任务,例如以子目录名作为类别标签,或用 metadata.jsonl 给每个结构附上分辨率等属性,这是 PDB 加载 PR 中给出的用法示例。三是数据共享与复现:处理好的数据集可以推送到 Hub 并配上数据集卡片,合作者用 load_dataset() 即可取得同一份数据。已经用 Datasets 管理文本或图像数据的课题组,把生物数据纳入同一套流程的迁移成本较低。
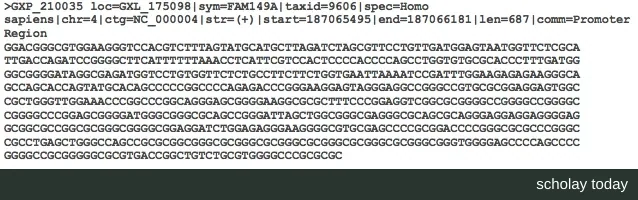
一条 FASTA 记录:以“>”开头的首行写序列名称和说明,其后各行是碱基序列。按 PR #7923 的说明,Datasets 读取时首行第一个词进入 id 列,其余文字进入 description 列,序列各行合并为 sequence 列,整条记录的原始字节另存于 record 列。图片:LarsonGCD,来源 Wikimedia Commons(File:FAM149A Promoter region (FASTA format).png),许可 CC BY-SA 3.0。
局限与注意事项
首先,读得进来不等于能做分析。5.1.0 解决的是文件读取和数据组织,不做测序质量控制、序列比对、注释或结构计算,这些仍要交给专门的生物信息学软件。PDB 和 mmCIF 加载器在开发中一度把文件解析成原子级坐标表,合并前这套自研解析器被移除,改为整份文件存成一行、解码交给 Biopython;想直接得到原子坐标列,需要自己在 map() 里转换。
其次,结果取决于是否安装 Biopython。不安装时,FASTA 仍有解析好的序列列,record 列需要用 columns 去掉或设为 decode=False;PDB 和 mmCIF 只能拿到原始字节。PR 作者还写明一处行为差异:Biopython 的普通 fasta 解析器会把以分号开头的 Pearson 注释行留在序列里,而 sequence 列会去掉这些行,两处得到的序列可能不一致。贡献者自测,用 Biopython 解析 FASTA 的耗时约为内置解析器的 2.1 至 2.2 倍;这是开发者的测量,本文没有复现。
再次,这批功能是第一次进入正式版。同一版本里已经修复了 GenBank 负链多外显子位置区间反转、单独 CR 换行导致解码出错等问题,说明边界情况仍在暴露。升级还会带来依赖变化,pyarrow 不低于 24.0.0 等要求可能与现有环境冲突;用于论文实验时,宜固定版本号并写进方法部分。
想先判断是否合用,可以做一个小规模验收(这是建议,本文未执行):取一个几百条记录的 FASTA 文件和十来个 PDB 或 mmCIF 文件,分别在安装与未安装 Biopython 的环境里用 load_dataset() 读入,核对记录数、序列长度和链数是否与原文件一致,再检查含注释行、压缩文件和多模型结构的样本是否读对。
参考文献
-
Release 5.1.0. huggingface/datasets,GitHub,2026-10-05 发布。
-
Releases. huggingface/datasets,GitHub,2026-10-20 核验。
-
huggingface/datasets. GitHub,2026-10-20 核验。
-
LICENSE(Apache License 2.0). GitHub,2026-10-20 核验。
-
setup.py(5.1.0 标签). GitHub,2026-10-20 核验。
-
PR #8542: add BioSequence and BioStructure decodable features. GitHub,2026-09-10 合并。
-
PR #7923: add lightweight FASTA file format support. GitHub,2026-09-11 合并。
-
PR #7926: Add lightweight PDB (Protein Data Bank) file support. GitHub,2026-09-11 合并。
-
信息由 Scholay 学术一站式平台 整理并发表,如有侵权请反馈下架。
-
信息同步发表于恩特学术,智能时代的学者社区
在交互式日历中查看这条记录 ↗