为何收录
对科研用户来说,Haystack 的用处在于把文献检索、证据整理和模型生成拆成可以单独替换、单独检查的组件:文档怎样切分,用 BM25 还是向量检索,检索结果怎样排序后再交给模型,都由使用者显式配置,每一步的输入输出也可以追踪。最近两个版本的改动多数落在这些环节上,和“生成的引用能否对上原文”直接相关。它适合用 Python 搭建文献问答、系统综述辅助检索或课题组内部知识库的研究者;只想直接用现成问答工具的读者,学习成本偏高。
长任务中的工具结果外存
智能体执行长任务时,检索、读取网页等工具的返回结果会不断累积,最终超出模型的上下文窗口。常见做法是删掉较早的工具结果,或把它们压缩成摘要,代价是原始内容再也查不到。v3.4.0 为 CompactionHook 新增了实验性的 ToolResultOffloadCompactor:触发压缩时,它不删除也不摘要旧的工具结果,而是把它们写入 ToolResultStore,在对话中留下一条引用;智能体需要时,可以通过一个限定在同一存储上的读取工具取回完整内容。触发压缩之前,新结果照常留在上下文中,所以短任务没有额外开销。
官方示例用 FileSystemToolResultStore 把结果存到本地目录,读取工具由使用者自己用 @tool 定义后交给智能体。同一版本还修正了一个相关问题:写入存储失败时(例如磁盘已满),智能体不再中断运行,该结果留在对话中并记录一条警告。对需要连续检索、阅读几十篇论文的任务,这种做法保留了回到原始检索结果核对的可能。它只是一种上下文压缩策略,不判断证据真伪,也不是完整的研究记忆系统;目前标为实验性,接口仍可能变化。
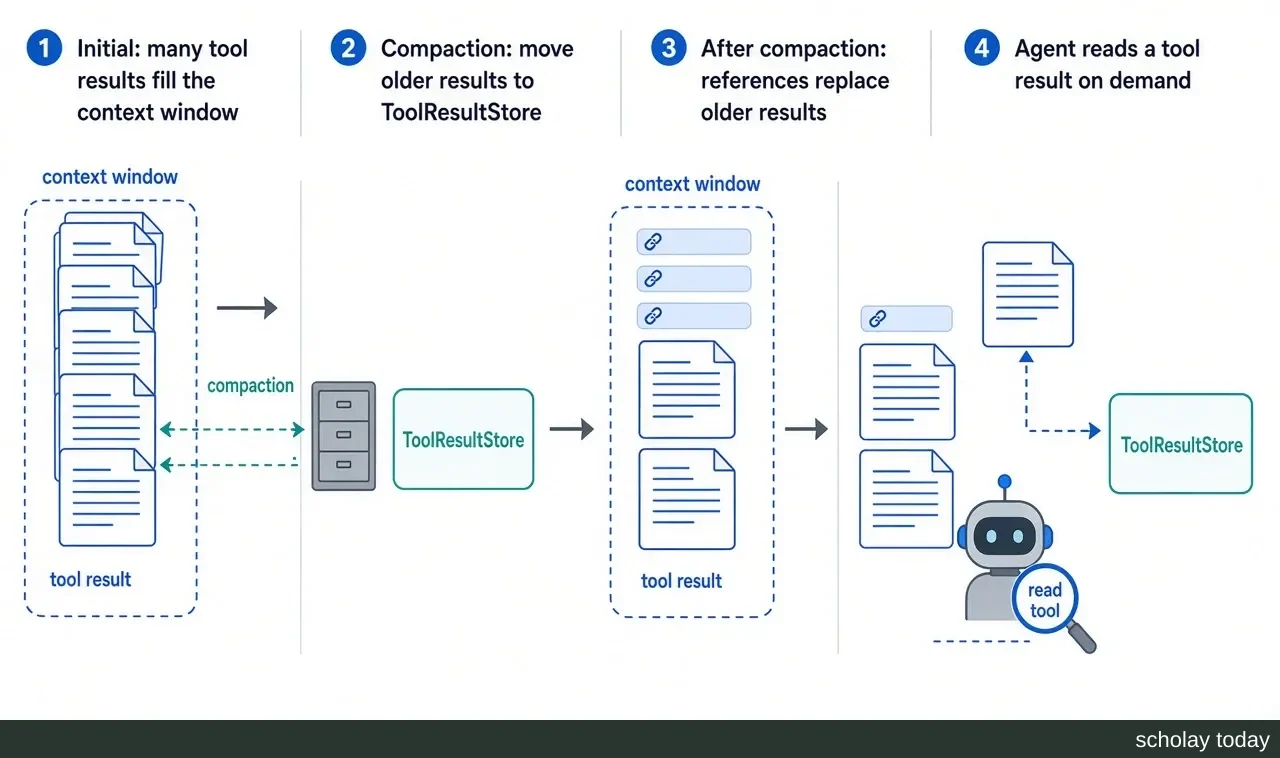
ToolResultOffloadCompactor 的工作流程:工具结果累积到触发压缩后,较早的结果写入 ToolResultStore,上下文中只保留引用;智能体需要时通过读取工具取回完整内容。AI 生成示意图,依据 Haystack v3.4.0 发布说明绘制,非官方截图。
分块页码与原文对齐
做文献问答时,模型给出的结论能否落到“第几页、哪一段”,取决于文档分块时记下的元数据。v3.4.0 统一了各分块组件中 page_number 的含义:一律表示文本块开始所在的页。此前 RecursiveDocumentSplitter 记录的是文本块结束的页;DocumentSplitter、MarkdownHeaderSplitter 和 EmbeddingBasedDocumentSplitter 遇到以分页符(\f)开头的文本块,会把它标成前一页,尽管其中文字全在后一页。
RecursiveDocumentSplitter 的几处问题也一并修正:设置重叠(split_overlap 大于 0)时,页码会逐块向上漂移,甚至超过文档总页数;按词切分并重叠时,文本块由词语加单个空格重新拼接,会多出原文没有的空格、合并换行、丢失分页符;按句切分时句间空白被丢掉,split_idx_start 偏离文本块的真实起点。新版改为直接从原文复制文本块,并按文本块在原文中的偏移计算页码。上一版 v3.3.0 修过同类问题:SentenceSplitter 遇到以右引号结尾的句子会丢失句间空白,使后续文本块无法映射回原文。官方提示,向用户展示页码或把页码与向量一起存储的项目,应对受影响的文档重新建索引。
v3.3.0 的检索修正
10 月 1 日发布的 v3.3.0 主要修正检索质量。内存文档库的 BM25 检索使用 BM25L(默认)或 BM25Plus 时,此前不含任何查询词的文档也可能得到正分并占满 top_k;新版只返回至少包含一个查询词的文档,结果可能少于 top_k 甚至为空,匹配文档的分数也比以前低,BM25Okapi 不受影响。对文献检索来说,返回空结果比拿无关文献凑数更容易暴露“库里其实没有证据”。同一版本修正了内存文档库对中文、日文和韩文的 BM25 分词:默认把每个汉字切成一个词元,让查询词能匹配到无空格长句中的片段,并在分词前做 Unicode NFC 规范化。此外,SentenceWindowRetriever 改为每次运行只查询一次文档库,输出不变;ChatPromptBuilder 不再静默丢弃模板中的图片、文件和额外文本。v3.4.0 又修正了 SentenceWindowRetriever 在文本块缺少 split_idx_start 时拼接顺序错乱的问题。
局限与升级注意事项
几项改动会改变已有结果,升级前宜在测试环境比对。v3.4.0 把 OpenAI 和 Azure OpenAI 嵌入组件的默认模型从 text-embedding-ada-002 换成 text-embedding-3-small,两者生成的向量互不兼容,已有向量库要么显式指定旧模型,要么全部重新嵌入。分块和 BM25 的修正会改变文本块边界、页码和检索分数,依赖固定分数阈值或旧页码的流程需要重新校准。FilterPolicy.MERGE 合并两个 OR 或 NOT 过滤条件时由并集改为交集;HTMLToDocument 的默认编码处理改为交给 Trafilatura 自动检测。
中文检索方面,按单字切分让查询更容易命中,但不再利用词语边界,排序效果是否够用,需要在自己的语料上验证。Haystack 默认收集匿名的组件使用统计,v3.4.0 起智能体在流水线中运行时还会上报聊天生成器的类名和工具清单;处理敏感资料的课题组可以按官方文档关闭遥测。框架本身不提供模型,回答质量取决于接入的模型和语料;使用外部 API 还涉及费用和数据外传,需要结合所在机构的数据政策选择本地或云端模型。
想先确认是否合用,可以做一个小规模验收(这是建议,本文未执行):选 5 到 10 篇自己领域的论文,转换为 Document 后分别用 DocumentSplitter 和 RecursiveDocumentSplitter 切分,抽查若干文本块的 page_number 与原文实际页码是否一致;再准备几条中文查询,其中一条在库中确实没有答案,观察 BM25 检索是否如新版说明那样返回空结果。
参考文献
-
deepset-ai/haystack. GitHub,2026-10-20 核验。
-
LICENSE(Apache License 2.0). GitHub,2026-10-20 核验。
-
README. GitHub,2026-10-20 核验。
-
Release v3.4.0. GitHub,2026-10-15 发布。
-
Release v3.3.0. GitHub,2026-10-01 发布。
-
Tags. GitHub,2026-10-20 核验。
-
信息由 Scholay 学术一站式平台 整理并发表,如有侵权请反馈下架。
-
信息同步发表于恩特学术,智能时代的学者社区