学术资源 / 固定快照
mpcrl 1.4.1 可分别配置两个 MPC
mpcrl 是一个 Python 库,用参数化的模型预测控制(MPC)充当强化学习智能体的策略与价值函数近似,再由强化学习算法调整 MPC 的参数。2025 年 10 月 17 日发布的 1.4.0 和 1.4.1 允许为两类价值函数分别传入 MPC,并改进了智能体的复制与序列化。本文为资料核验,未安装实测。 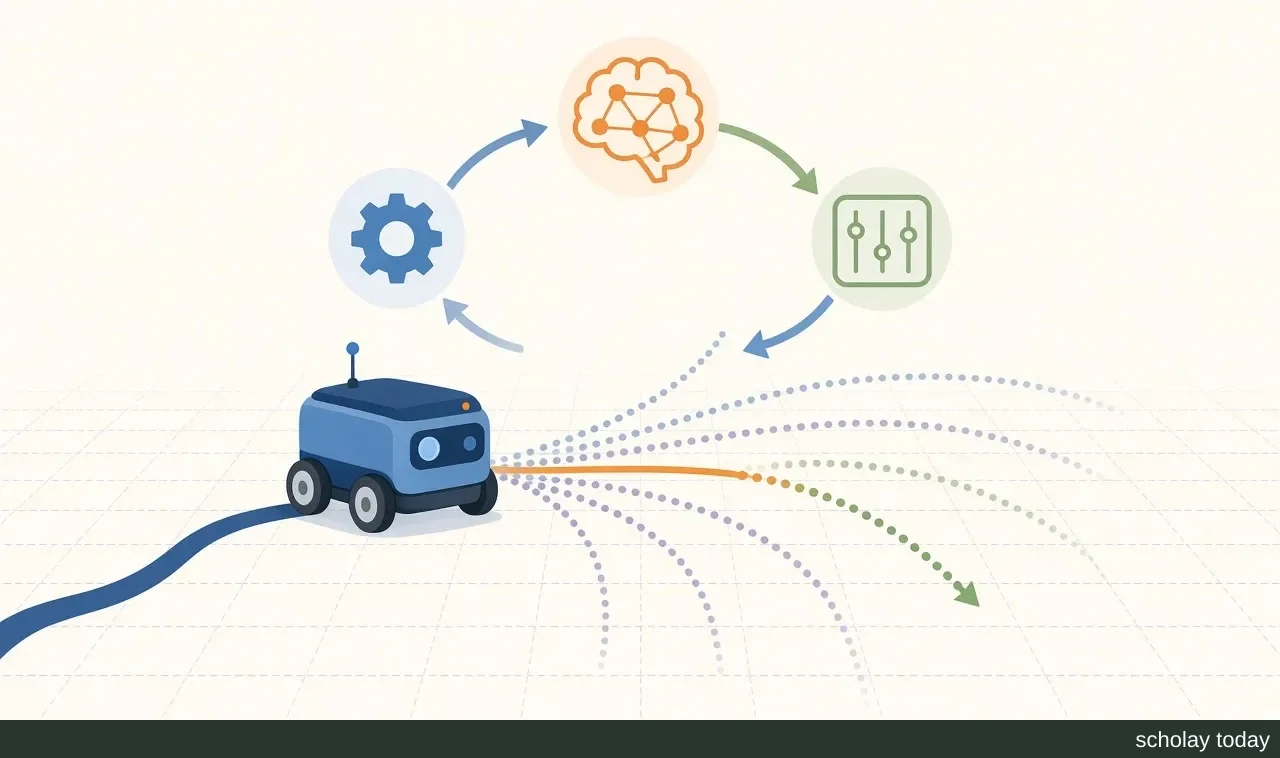 控制与学习的闭环:控制器沿预测轨迹选择动作,学习模块依据反馈调整参数(AI 生成示意图,非 mpcrl 官方图片) 官方 README 把这一框架称为“RL with/using MPC”,并指出它最早由 Gros 和 Zanon 在 2020 年的论文中提出。MPC 依据预测模型计算未来一段时域内的最优动作;在 mpcrl 里,MPC 的目标函数、预测模型和约束(或其中一部分)写成带参数的形式,它既向环境输出动作,又充当状态价值函数 V(s) 和状态—动作价值函数 Q(s,a) 的近似。强化学习算法根据环境返回的代价调整这些参数,让控制器的表现逐步改善。官方示例使用 Q-learning 和确定性策略梯度(DPG),也给出了用贝叶斯优化免梯度调参的例子。 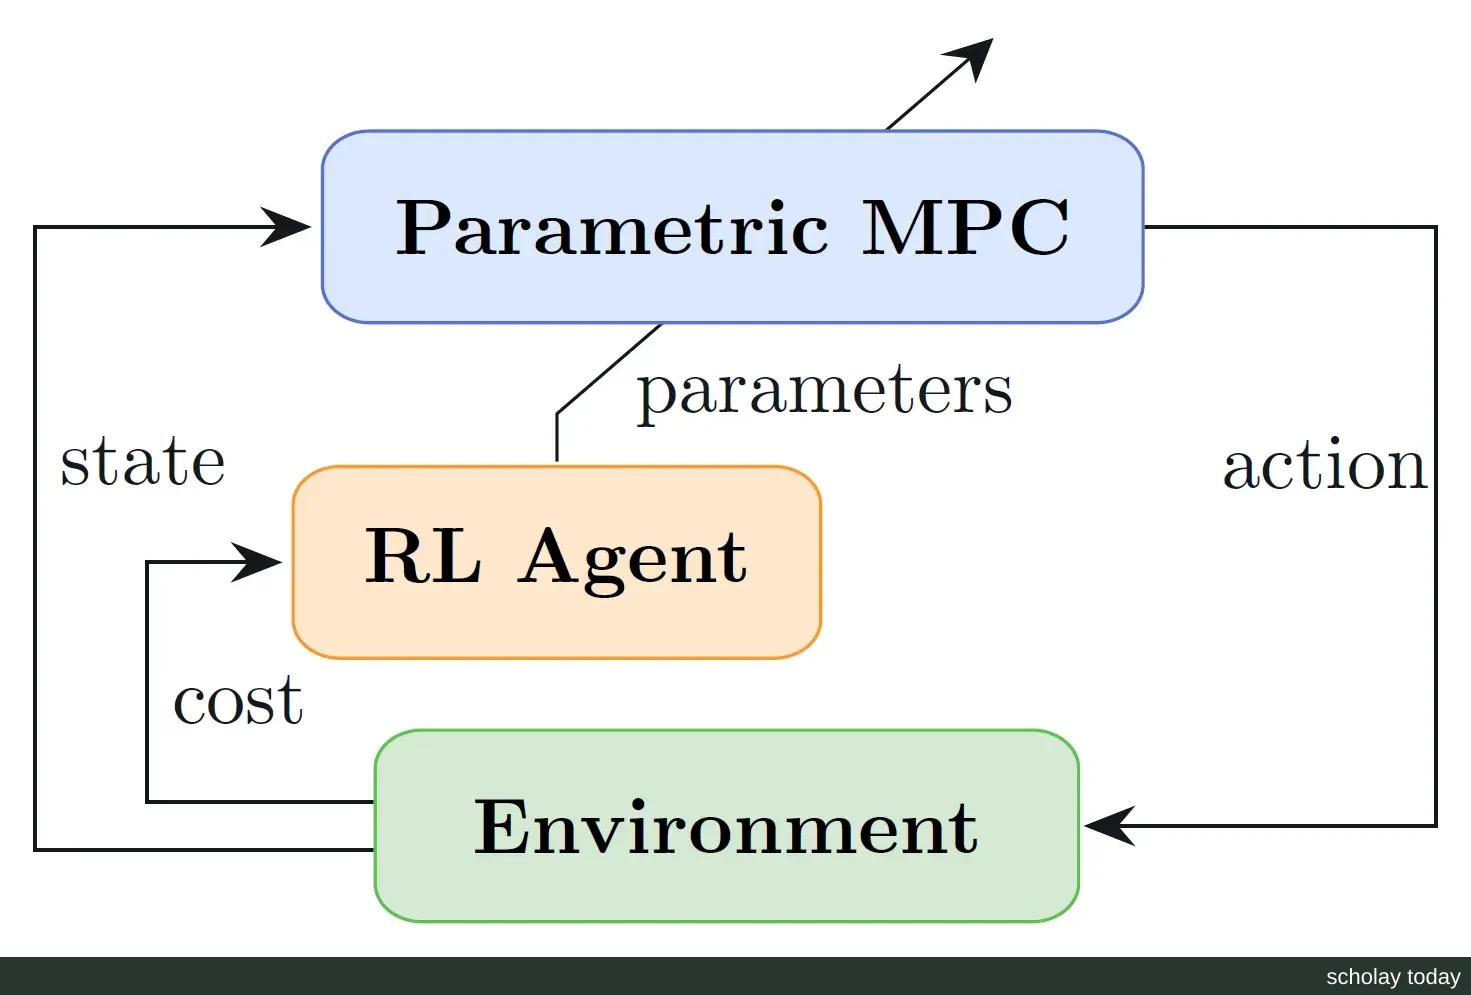 mpcrl 的框架示意:参数化 MPC 向环境输出动作,强化学习智能体依据状态和代价更新 MPC 参数(图:Filippo Airaldi,来源:mpcrl GitHub 仓库 docs/_static,MIT 许可) 使用时需要准备三样东西:一个 Gymnasium 格式的环境,由 reset 和 step 方法返回状态与代价;一个用 csnlp 构建的参数化 MPC,csnlp 是基于 CasADi 的优化建模包;以及待学习的参数和初始值。README 的入门示例用线性时不变系统演示这一流程:环境的真实矩阵对控制器未知,MPC 中的模型矩阵和代价矩阵作为可学习参数,LstdQLearningAgent 与环境交互训练后返回逐步的代价序列,示例用 IPOPT 求解 MPC。mpcrl 借助 csnlp 计算 MPC 最优解对参数的灵敏度,强化学习更新所需的梯度由此得到。 安装命令为 `pip install mpcrl`。1.4.1 在 PyPI 声明的依赖是 Numba、csnlp(1.6.8 及以上)、SciPy 和 Gymnasium,要求 Python 3.9 及以上,同时注明对 3.9 的支持和测试已经弃用。截至 2026 年 10 月 20 日,仓库 main 分支在 1.4.1 之后还有 67 个尚未发布的提交,其中一项把最低 Python 版本提高到 3.11,当前 README 也已按此改写。因此,从 PyPI 安装的仍是 1.4.1,直接从 main 分支源码安装则需要 Python 3.11。 仓库 LICENSE 为 MIT 许可证,版权人为 Filippo Airaldi;README 另附代尔夫特理工大学(TU Delft)放弃该程序版权权益的声明。作者在 README 中的身份是 TU Delft 代尔夫特系统与控制中心博士候选人。本文于 2026 年 10 月 20 日核对了 GitHub 仓库、Releases、1.4.1 标签源码和 PyPI 页面,属于资料核验,未安装实测。 ### 1.4.0 与 1.4.1 的改动 GitHub Releases 显示,1.4.0 和 1.4.1 都在 2025 年 10 月 17 日发布,相隔约 8 分钟。1.4.0 的主要变化是:所有智能体初始化时的 mpc 参数可以接收由两个 MPC 组成的元组,第一个用于构造 V(s) 的近似,第二个用于 Q(s,a)。官方说明,这样可以避免对单个 MPC 做代价较高的内部复制,也便于分别定制两个控制器。按 1.4.1 标签的源码,传入单个 MPC 依然可行,此时智能体会深复制出第二份,并就地修改传入的对象,文档建议初始化后不要再改动它。 1.4.0 还包含一项不兼容改动:`mpcrl.LearnableParameter` 不再接受 `sym` 参数,所需符号改为按名称从 MPC 控制器中读取。旧代码若在创建可学习参数时传入 `sym`,升级前需要修改相应调用。其余改动包括把测试扩展到 Python 3.13,完善文档字符串和类型标注,以及修复用户关闭或未提供热启动(warm start)时仍会使用热启动的问题。 1.4.1 的改动较少:借助 CasADi 的 `global_pickle_context` 和 `global_unpickle_context`,改进了对智能体做原生 `deepcopy` 和 pickle 序列化的支持;另外把代码检查工具换成 Ruff,并更新了文档依赖。发布说明没有交代序列化改进的测试范围,它能否满足保存、恢复完整训练状态的需要,还要在自己的实验里确认。
- 收录日期
- 2026-10-20
- 类别
- 基础设施
- 状态
- 资料核验,未安装实测
为何收录
mpcrl 面向基于学习的控制研究:控制器的结构来自已有的预测模型和约束,参数则从闭环数据中学习。它把 Gros、Zanon 等人发展的 MPC 型强化学习方法整理成可复用的代码,研究者不必自己推导 MPC 解对参数的灵敏度,也不必从头搭建 Q-learning 或 DPG 的更新流程,可以把精力放在问题建模和对比实验上。
官方示例库覆盖离线和在线 Q-learning、在线 DPG,以及用贝叶斯优化免梯度地调整 MPC 参数;README 说明这些主线示例都是小规模学术问题,例如一个小型线性时不变系统。示例库另收有凸多面体采样、带输入约束控制屏障函数的自适应巡航控制等例子,官方注明它们与 MPC 型强化学习并不直接相关。比较适合的读者,是已经熟悉 MPC 建模、想在仿真中让控制器参数随数据更新的控制方向研究生和研究人员。
1.4 系列的两项改动都落在实验工程上。V(s) 和 Q(s,a) 可以使用分别构造的 MPC,研究者能单独定制两个控制器,同时省去内部复制的开销。不过两者并不完全由用户决定:按 1.4.1 的源码,无论传入一个还是两个 MPC,智能体都会在 Q 的控制器上添加“首个动作等于给定动作”的约束,采用梯度型探索时还会在 V 的目标函数中加入扰动项。改进后的 deepcopy 与 pickle 支持,则方便复制智能体做多组重复实验,或把智能体对象保存到磁盘。
局限与注意事项
截至核验日,最新正式版本 1.4.1 发布已满一年。main 分支此后的提交包括依赖升级、代码检查配置更新和最低 Python 版本调整,还没有形成新的发布。打算在课题中长期使用的团队,宜锁定版本号,并留意后续发布说明。
这类方法每给出一个动作都要在线求解一次优化问题,非线性、非凸问题还可能求解失败。智能体为此提供了 use_last_action_on_fail 选项,以及基于多起点非线性规划的热启动策略,但它们只是工程上的应对,不能保证训练收敛或闭环稳定。若研究需要稳定性与安全性保证,应回到 README 所列 Gros、Zanon 等人的理论文献核对前提条件,不能默认库的实现已经提供这些保证。
环境须遵循 Gymnasium 接口,README 入门示例还注明状态和动作须为连续量。从旧版本升级时,除了检查 LearnableParameter 的 sym 参数,还要留意热启动行为:1.4.0 修复相关问题后,过去在关闭热启动的设置下实际仍使用了热启动的实验,重跑结果可能与原记录不同。
MIT 许可允许使用、修改和再分发,条件是在副本中保留版权声明和许可声明;软件按“原样”提供,不附任何担保。csnlp、CasADi 和 IPOPT 等依赖各有许可条款,本文没有逐一核对。
一个小规模的验收办法是:在独立虚拟环境中安装 1.4.1,运行官方的在线 Q-learning 示例,分别用单个 MPC 和 (V, Q) 元组初始化智能体,比较两次训练的代价曲线,再把训练后的智能体用 pickle 保存并重新读取。这是建议的检查步骤,本文没有执行。仓库名为 FilippoAiraldi/mpc-reinforcement-learning,项目入口:GitHub 仓库、1.4.1 发布页、官方文档、PyPI。
参考文献
参考文献
-
mpcrl.diagram.light.png 与 mpcrl.diagram.tex(1.4.1 标签 docs/_static)
-
信息由 Scholay 学术一站式平台 整理并发表,如有侵权请反馈下架。
-
信息同步发表于恩特学术,智能时代的学者社区
在交互式日历中查看这条记录 ↗