学术资源 / 固定快照
DSPy 3.4.1 更新了提示优化与子智能体
DSPy 是斯坦福 NLP 团队发起的开源 Python 框架(仓库 stanfordnlp/dspy,MIT 许可证),用声明输入输出的“签名”和可组合模块编写语言模型程序,再由优化器按评测指标调整提示。3.4.1 版于 2026 年 10 月 12 日(UTC)发布,GEPA 优化器默认改用结构化指令生成器,RLM 模块可在运行中构建子智能体。本文为资料核验,未安装实测。 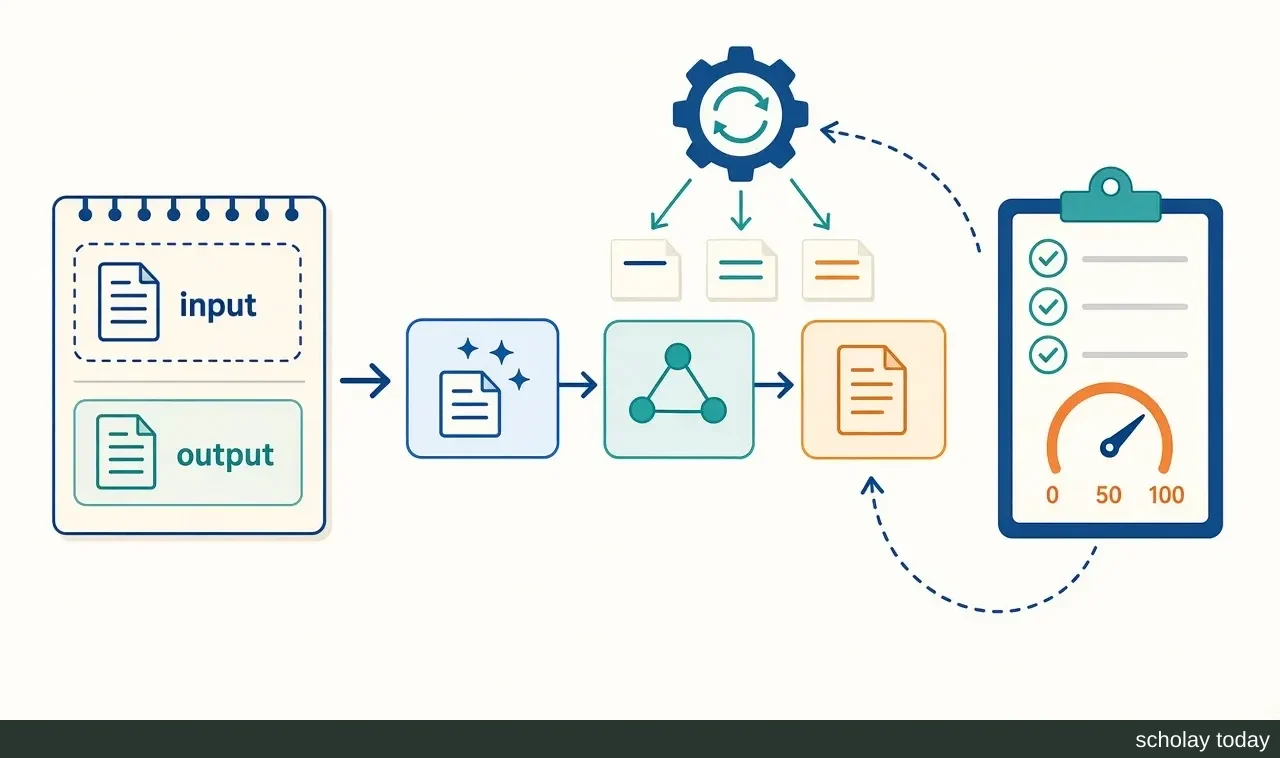 AI 生成示意图:左侧任务卡片代表声明输入与输出的签名,中间的模块串成流程,右侧评分板把分数反馈给优化器,优化器再改写各模块的指令,形成闭环。画面为概念示意,不是 DSPy 的界面截图。 ### 框架结构与安装 截至 2026 年 10 月 21 日核验,GitHub 仓库 stanfordnlp/dspy 未归档,创建于 2023 年 1 月,主要语言为 Python,最近一次推送在 10 月 20 日(UTC)。根目录 LICENSE 是 MIT 许可证,版权声明为“Copyright (c) 2023 Stanford Future Data Systems”,GitHub 元数据也识别为 MIT。DSPy 是调用语言模型的框架,实际使用的模型和接口服务另按各自的条款与计费。它的写法分三层:签名(Signature)用带类型的输入、输出字段声明任务,例如“摘要 → 研究设计、样本量”;模块(Module)决定签名怎样执行,`dspy.Predict` 直接生成,`dspy.ChainOfThought` 先推理再作答,`dspy.ReAct` 在推理循环中调用工具,多个模块可以用普通 Python 控制流组合;优化器以一组样例和一个评分函数为输入,自动改写各模块的指令或挑选示例,GEPA、MIPROv2 都属于这一层。官方给出的安装命令是 `pip install -U dspy`,要求 Python 3.10 及以上,3.4.1 声明支持到 Python 3.15。以上步骤本文没有在本机执行。 ### 3.4.1 版本更新 3.4.1 于 2026 年 10 月 12 日(UTC)发布,是 GitHub Releases 上目前最新的正式版,官方升级命令为 `pip install --upgrade "dspy==3.4.1"`。第一项主要变化在 GEPA。GEPA 是 DSPy 中的反思式优化器,出自 Agrawal 等人 2025 年的论文:它运行程序、收集推理过程和工具调用轨迹,让一个“反思模型”分析评分与文字反馈,再提出新的指令。3.4.1 起,未指定 `instruction_proposer` 时 GEPA 默认使用 `InstructionProposer`。旧做法把反思样例拼成一段原始文本,再从反引号里取出新指令;新做法通过 `dspy.Predict` 和 `JSONAdapter` 调用反思模型,`dspy.History` 对话历史、工具轨迹和 `dspy.Image` 等图像输入都以结构化内容传入,不再被替换成文本占位。使用者还可以给它提供参考材料(`skills`,可以是含 SKILL.md 的目录)、对每次提案都生效的附加要求(`additional_instructions`)和指令字数上限(`max_chars`);草稿超长时只尝试压缩一次,不会截断指令。发布说明特别指出,GEPA 原有的反思指令本身没有改。 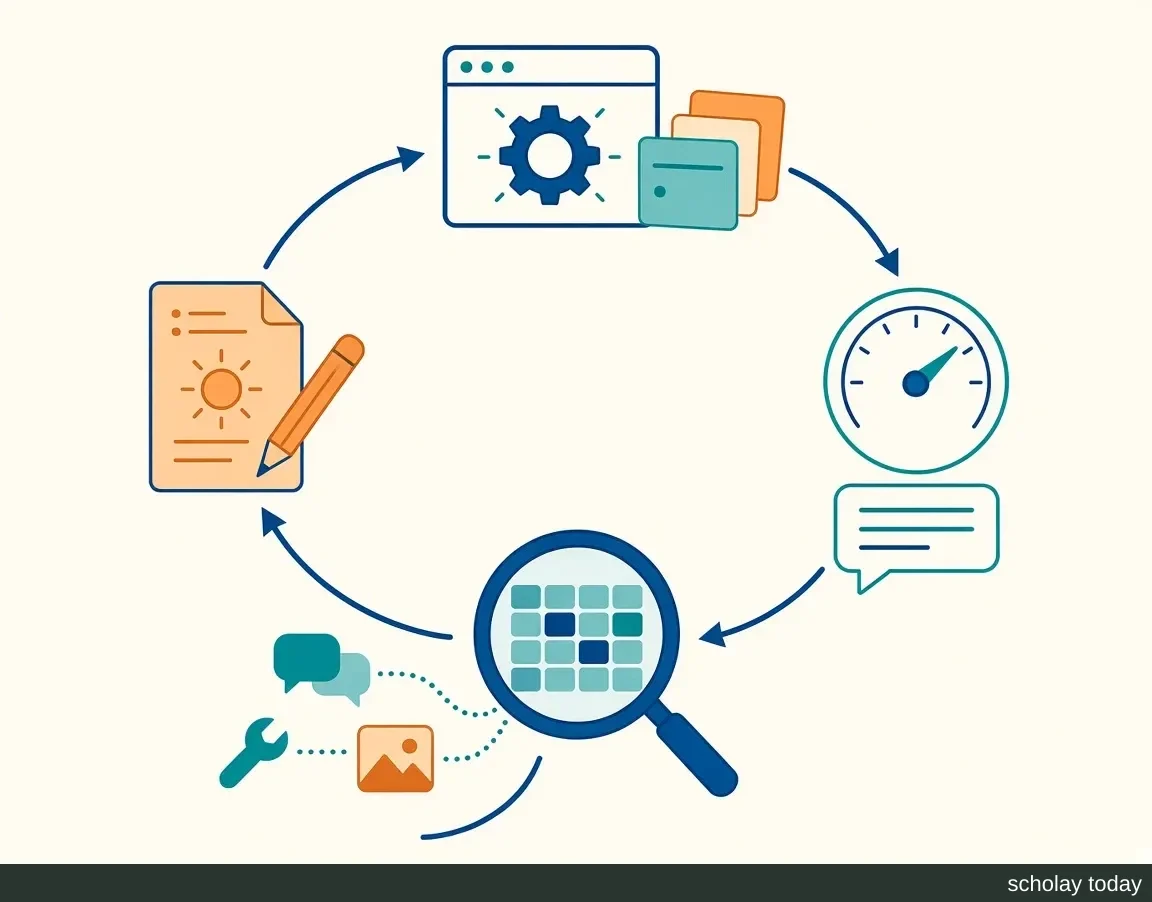 AI 生成示意图:GEPA 的反思优化循环。程序在样例上运行,评分函数给出分数和文字反馈,反思模型结合工具轨迹、对话历史和图像等结构化输入分析运行记录,提出新指令后再交回程序评测。 第二项变化在 `dspy.RLM`。RLM 即递归语言模型(Recursive Language Model),面向放不进上下文窗口的长材料:模型先只看到材料的类型、长度和预览,在沙箱化的 Python 环境里写代码查看、筛选数据,并可对片段发起子调用。3.4.1 起,RLM 写出的代码可以 `import dspy`,现场构建 `dspy.Predict`、`dspy.ChainOfThought`、使用同一组工具的 `dspy.ReActV2` 或嵌套的 `dspy.RLM`,作为处理子任务的子智能体。子智能体在宿主进程中构建和运行,跨越解释器边界的只有 JSON。所有子智能体调用和 `llm_query` 一起计入 `max_llm_calls` 这一个预算;沙箱中的代码只能设置温度、最大长度等生成参数,不能改模型名、接口地址或密钥。该功能对所有 RLM 默认开启,没有关闭选项。 同一版本加入了 Python 3.15 支持,但在 3.15 上不会安装 litellm 和 gepa 两个依赖:需要 LiteLLM 回退的模型路由不可用,调用 `dspy.GEPA` 会直接报 ImportError。此外还修复了 3.4.0 中可能出现的 `openai._models` 导入崩溃,以及流式输出、适配器和工具默认参数序列化等问题。3.4.0 预告的语言模型接口调整仍然有效:旧式自定义 `forward()`/`aforward()` 语言模型和 OpenAI 风格的 `messages=` 调用等写法将在 3.5 中移除,`lm("hello")` 这种调用继续保留。
- 收录日期
- 2026-10-21
- 类别
- 科研 Agent
- 状态
- 资料核验,未安装实测(2026-10-21)
为何收录
不少研究组已经用大模型做文献筛选、信息抽取、数据标注和分析辅助,提示词多靠反复试错手工调整,改了一句话之后效果变好还是变坏,常常说不清。DSPy 把这件事当作有数据、有指标的优化问题:先用签名和模块写出流程,再准备一组带人工标准答案的样例和评分函数,例如“抽取的样本量与人工标注是否一致”或“纳入排除判断的 F1 值”,由优化器在训练集上改写指令,再在独立的验证集上比较前后得分。这样,提示词的每次修改都对应可复查的分数和保存下来的程序文件(save() 输出的 JSON),论文的方法部分也能写清用了哪个模型、哪个优化器、多少样例。
3.4.1 的两项变化与科研流程有直接关系。GEPA 的反思输入保留了工具轨迹和图像,更适合优化需要检索、调用计算工具或读图的流程,例如从论文图表中读取数值;skills 参数则可以把课题组已有的标注规范交给反思模型作参考。RLM 的子智能体面向长材料:处理一批访谈转录或一份很长的实验日志时,模型可以自行切分,再为“逐段提取错误”“汇总证据”这类子任务临时搭建结构化模块,所有调用受同一个次数上限约束。在论文中报告用法时,可引用 DSPy 的原始论文(arXiv:2310.03714)和 GEPA 论文(arXiv:2507.19457)。
局限与注意事项
- 结果复现:3.4.1 改变了 GEPA 默认反思请求的格式,官方说明即使随机种子相同,优化结果也可能与 3.4.0 不同;RLM 提示词和
X | Y 类型注解的渲染方式也有变化,3.4.0 下的缓存和录制的模型响应不再命中。用作研究方法时,应锁定 DSPy 版本,保存评测数据、优化后的程序文件和所用模型名称。
- 反思模型:反思模型必须是
dspy.LM 或其他 dspy.BaseLM,并能返回可解析的 JSON。若模型用纯文本或代码块作答,提案会失败,GEPA 只在日志中记录并保留当前候选,整轮运行结束时程序可能根本没有被优化,需要检查日志,而不能只看是否跑完。
- 兼容性:
dspy.ReActV2 的签名不能再声明名为 history 或 tools 的输入;在 3.4.0 中保存、含空(null)Score 等级描述的程序无法加载;重写 format_user_message_content 的自定义适配器需要增加 main_request 参数。离线使用内置模型元数据时,部分旧模型会失去工具调用、结构化输出等能力标记,DSPy 会在不提示的情况下改变请求方式。
- Python 3.15:在 3.15 上不安装 gepa 与 litellm,
dspy.GEPA 不可用,需要 GEPA 的项目应停留在 3.10–3.14。
- 沙箱与数据:RLM 依赖 Deno 和 Pyodide 构建本地 WASM 沙箱;若改用在宿主进程中以
exec() 执行代码的解释器,调用预算和参数限制只能约束正常编写的代码,官方建议仅用于可信代码。所用模型若是外部 API,样例数据会发送给服务商,涉及受保护数据时需要另行评估。
- 评测设计:优化器只会朝评分函数指示的方向改进。样例太少或指标设计不当时,验证集上的提升未必能推广到新数据。
想先判断是否合用,可以做一个小规模验收(这是建议,本文未执行):从课题组已有的人工标注中取 50 条摘要,分成训练集 30 条和验证集 20 条,用 dspy.ChainOfThought 写一个抽取研究设计与样本量的程序,先记录未优化时的验证集得分,再在固定的 3.4.1 版本下用 dspy.GEPA 优化并比较前后得分,同时人工检查优化后的指令是否引入了与标注规范不符的规则。
参考文献
-
stanfordnlp/dspy. GitHub,2026-10-21 核验。
-
LICENSE(MIT License). GitHub,2026-10-21 核验。
-
DSPy 3.4.1. GitHub Releases,2026-10-12(UTC)发布。
-
DSPy 官方文档首页. 2026-10-21 核验。
-
dspy.RLM. DSPy 文档,2026-10-21 核验。
-
dspy.GEPA: Reflective Prompt Optimizer. DSPy 文档,2026-10-21 核验。
-
Khattab O, Singhvi A, Maheshwari P, et al. DSPy: Compiling Declarative Language Model Calls into Self-Improving Pipelines. arXiv:2310.03714,2023。
-
Agrawal L A, Tan S, Soylu D, et al. GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning. arXiv:2507.19457,2025。
-
信息由 Scholay 学术一站式平台 整理并发表,如有侵权请反馈下架。
-
信息同步发表于恩特学术,智能时代的学者社区
在交互式日历中查看这条记录 ↗