学术资源 / 固定快照
PyGAD 3.8 修正了选择与交叉偏差
PyGAD 是用 Python 构建遗传算法的开源库,仓库为 ahmedfgad/GeneticAlgorithmPython,采用 BSD-3-Clause 许可证。2026 年 10 月 9 日和 11 日先后发布的 3.8.0 与 3.8.1 修正了排序选择、SBX 交叉和整数变异中的偏差与溢出,同一随机种子下的结果可能与旧版不同。本文为资料核验,未安装实测。 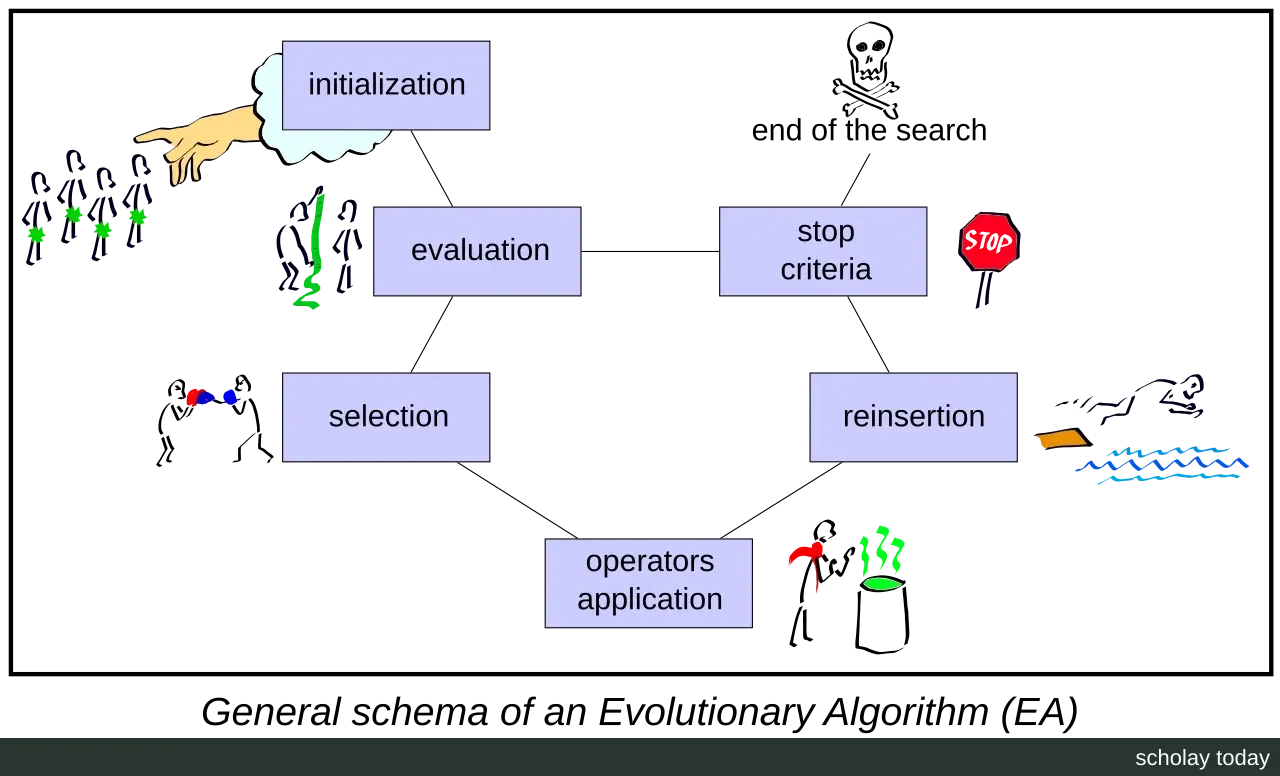 演化算法的一般过程示意。遗传算法是演化算法的一类,PyGAD 提供的父代选择、交叉和变异算子对应这一过程中的各个环节;本图是通用算法示意,不是 PyGAD 的界面或运行结果。图:Jorge.maturana,来源 [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Evolutionary_Algorithm.svg),许可 [CC BY 3.0](https://creativecommons.org/licenses/by/3.0/)。 ### 仓库、许可与使用方式 截至 2026 年 10 月 21 日核验,GitHub 仓库 ahmedfgad/GeneticAlgorithmPython 创建于 2018 年 12 月,未归档,最近一次推送在 10 月 17 日(UTC),文档位于 pygad.readthedocs.io。根目录 LICENSE 是 BSD 三条款许可证正文,版权声明为“Copyright GeneticAlgorithmPython Contributors”,GitHub 元数据同样识别为 BSD-3-Clause:允许修改和再分发,须保留版权声明和免责条款,且未经书面许可不得用版权人或贡献者的名义为衍生产品背书。项目要求 Python 3.8 及以上,核心依赖只有 NumPy 和 cloudpickle;绘图需要 matplotlib,生成 PDF 报告另需 reportlab,Keras、TensorFlow、PyTorch 属于可选的深度学习依赖。官方文档给出的安装命令是 `pip3 install pygad`,本文没有在本机执行。 使用 PyGAD 的核心是自己写一个适应度函数:它接收一个候选解(一组基因值),返回一个分数,分数越高表示解越好。函数返回单个数值时按单目标问题处理,返回列表、元组或 NumPy 数组时按多目标问题处理。随后在 `pygad.GA` 中设定代数、种群规模、基因数量和初始取值范围,以及父代选择、交叉和变异方式,调用 `run()` 运行,再用 `best_solution()` 取出最优解。库内按用途分成若干模块:`pygad.utils` 存放交叉、变异、父代选择算子和 NSGA-II、NSGA-III 多目标算法,`pygad.visualize` 负责绘图,`pygad.gann`、`pygad.kerasga`、`pygad.torchga` 用遗传算法训练神经网络或 Keras、PyTorch 模型。作者 Ahmed Fawzy Gad 在《Multimedia Tools and Applications》上发表过介绍该库的论文,文档建议使用者引用。 ### 3.8 版的修正与后续版本 3.8.0 的发布说明注明发布日期为 2026 年 10 月 9 日,GitHub 上的发布记录时间为 10 月 10 日(UTC),共列出 35 项改动,其中几项直接关系到算法是否按定义运行。排序选择(rank selection)本应按适应度从好到坏排名,排名越靠前的解越容易被选为父代;旧实现存在偏差,反而让较差的解获得更高的选择概率。新版改为按从优到劣的顺序分配递减权重,并用回归测试核对精确概率、负适应度、多目标向量和并列排名(issue #120)。SBX 交叉(模拟二进制交叉)原先偏向数值较低的子代,现在以相等概率取较低或较高的一个(PR #376)。两点交叉的两个切点改为在全部位置中等概率抽取,单基因时不再报切片错误(PR #371);交换变异可以选中任意两个不同位置(PR #375);随机通用抽样按实际请求的父代数量设置指针间距(issue #85);打乱变异可以产生选定片段的任意排列(issue #76)。 同一版本还调整了几处影响复现和诊断的机制。每个 `GA` 实例改为持有自己的 NumPy 和 Python 随机数生成器,检查点会保存生成器状态,自定义算子和回调也能调用这两个生成器。并行适应度计算在串行、线程和进程三种模式下使用相同的缓存与校验规则;适应度出现 NaN、空向量或目标数量不一致时,会在父代选择之前直接报错。`saturate_N` 停止条件改为检查连续未变化的代数,`saturate_1` 不再让仍在改进的运行提前停止。新增的 `plot_lifecycle()` 方法可以画出当前实例配置的算子、回调和停止条件,并导出为 SVG、PNG 或 PDF。发布说明同时提醒:各算子消耗随机数的方式变了,同一个 `random_seed` 在同一版本和环境中仍可复现,但结果可能与旧版本不同。 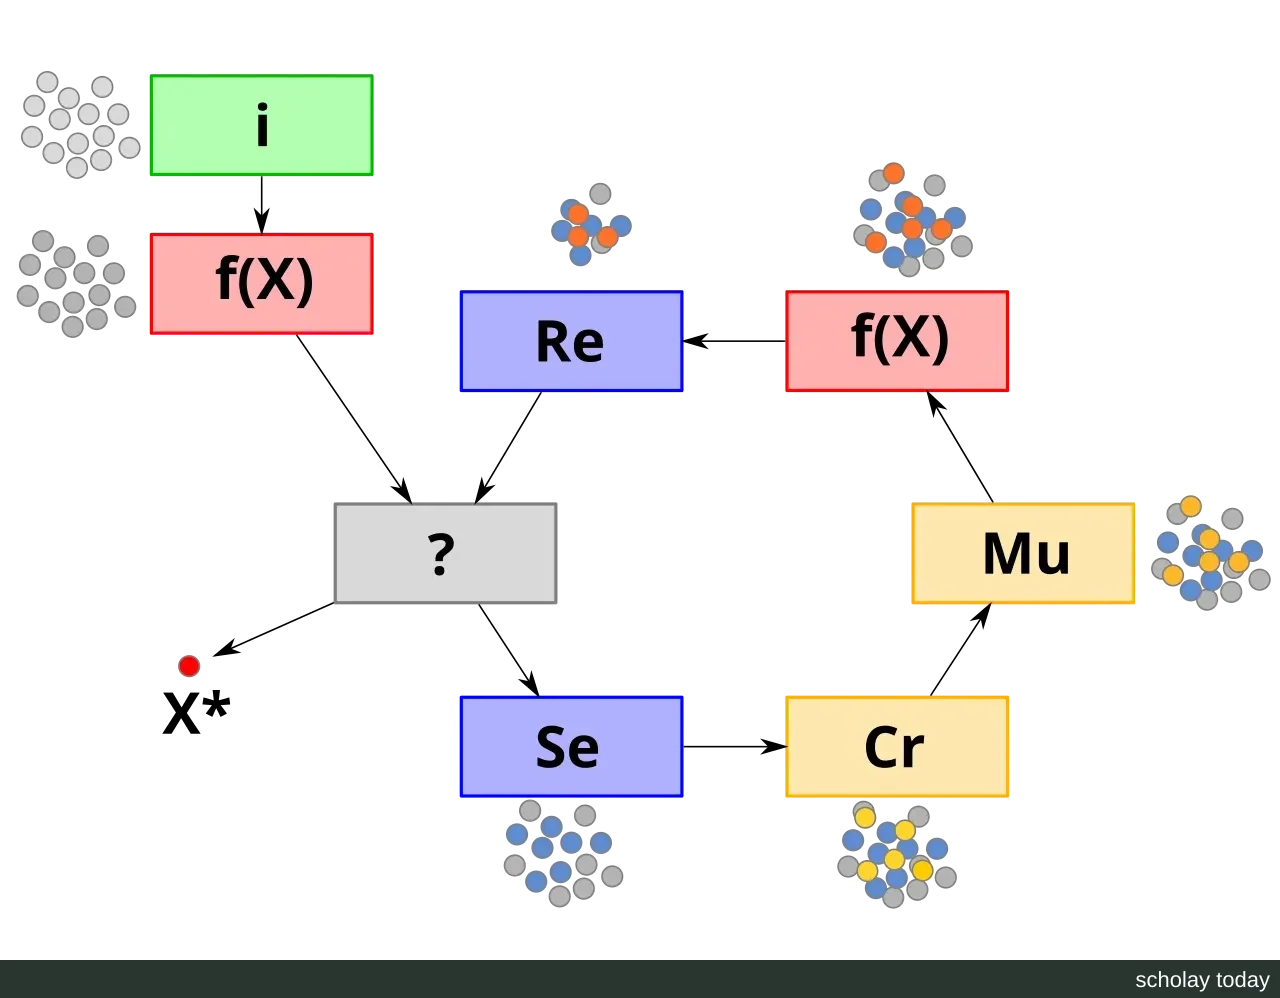 演化算法的循环:i 为初始化,f(X) 为评估,? 为停止判断,Se 为选择,Cr 为交叉,Mu 为变异,Re 为替换,X* 为输出的最优解。PyGAD 3.8.0 修正的排序选择和随机通用抽样属于 Se 环节,SBX 与两点交叉属于 Cr 环节,交换变异、打乱变异以及 3.8.1 的窄整数裁剪属于 Mu 环节。本图是通用算法示意,不是 PyGAD 官方图或运行结果。图:Johann “nojhan” Dréo,来源 [Wikimedia Commons](https://commons.wikimedia.org/wiki/File:Evolutionary_algorithm.svg),许可 [CC BY-SA 3.0](https://creativecommons.org/licenses/by-sa/3.0/)。 3.8.1 于 2026 年 10 月 11 日发布,处理的是整数基因。当使用者显式指定 `numpy.uint8`、`numpy.int8` 这类窄整数类型时,随机变异和自适应变异生成的数值可能超出类型范围,转换时报溢出错误,或者发生回绕,也就是越界的数从另一端绕回来,类似 uint8 中 256 变成 0。新版在转换前先把数值裁剪到该类型的上下限之内,同一规则覆盖加性与替换式变异、约束候选值和重复基因修复(issue #379)。另一项修复针对 Windows 上的 NumPy 1.x:Python 整数现在统一以有符号 64 位存储,解决了大整数转换和种群初始化失败的问题;使用者自己提供的 Python 整数种群值必须落在 64 位范围内,更大的整数需要设 `gene_type=object`。持续集成现在在 Windows 上同时测试 NumPy 1.24.4 和最新版,此前在 NumPy 1.24.4 下失败的 16 个 Windows 测试已修复,最低 NumPy 版本没有提高。 3.8.1 已不是最新版本。截至 10 月 21 日,GitHub Releases 上还有 10 月 16 日连续发布的 3.9.0、3.9.1 和 3.9.2,文档首页却仍写着当前版本为 3.8.1。3.9.0 让 SBX 交叉和多项式变异对整数基因四舍五入而不是截断:此前整数基因的最大值几乎取不到,数值被拉向零,因此同一种子下整数基因的结果会改变;这一版还新增 `gene_categorical` 参数,用于没有大小顺序的类别型基因。3.9.1 修正了轮盘赌选择和随机通用抽样处理负适应度的方式。旧做法直接用适应度除以总和,负值会把优劣顺序颠倒,发布说明举例说,适应度为 -1 和 -9 时,较差的那个解拿到 90% 的选择机会。3.9.2 又修复了适应度接近浮点上限时这两种选择方法的溢出。
- 收录日期
- 2026-10-21
- 类别
- 数据与评测
- 状态
- 资料核验,未安装实测(2026-10-21 核对 GitHub 仓库、Releases、LICENSE 与 pyproject.toml)
为何收录
遗传算法是一类不依赖梯度的全局搜索方法,适合目标函数不可导、含离散变量或存在多个局部最优的问题。科研中常见的用法包括:标定仿真模型参数,让模拟输出贴近观测数据;从大量变量中挑选特征子集;调整机器学习模型的超参数;在工程设计中同时权衡几个相互冲突的目标。PyGAD 的门槛较低,研究者只需用 Python 写出“给定一组参数,算出一个分数”的函数,就能接上现成的选择、交叉、变异算子和 NSGA-II、NSGA-III 多目标算法,比从头实现一套遗传算法省事,也便于在论文中交代所用的算子和参数。
这几个版本对已有研究的直接意义在于复核。选择和交叉中的偏差不会让程序报错,收敛曲线也可能照常下降,但实际的搜索过程已经偏离算法的定义。如果过去的实验在旧版 PyGAD 中用了排序选择、SBX 交叉、两点交叉或交换变异,或者在轮盘赌选择、随机通用抽样中使用过负适应度(例如把误差取负作为适应度来做最小化),或者给基因指定了窄整数类型,建议在新版本下重跑关键实验,比较最优解和适应度有没有实质变化。3.8.0 起的实例级随机数生成器和检查点中保存的随机状态,也让“固定版本加固定种子”的复现更可靠。由于同一个种子在不同版本间不会给出相同结果,论文方法部分应写明所用 PyGAD 的具体版本号。
局限与使用注意
遗传算法是启发式方法,不保证找到全局最优,结果依赖种群规模、代数、变异率等设置,通常需要用多个随机种子重复运行并报告结果分布,而不是只报一次最好成绩。总耗时主要取决于适应度函数本身:如果每次评估都要跑一次仿真或训练一个模型,评估次数很快会成为瓶颈,PyGAD 的线程和进程并行可以分摊等待时间,但不会降低单次评估的成本。用遗传算法训练神经网络是一种不需要梯度的做法,面对参数量大的深度模型时,基于梯度的训练通常效率更高。维护方面,pyproject.toml 中列出的作者和维护者都是 Ahmed Gad 一人;10 月 9 日至 16 日的一周里发布了 3.8.0 到 3.9.2 共五个版本,修复节奏快,也意味着行为变化频繁。建议在依赖文件中锁定具体版本,升级前逐条阅读发布说明。
想判断升级对自己实验的影响,可以先做一个小规模核对(建议做法,本文未执行):选一个已知最优解的测试函数,固定随机种子,分别在原先使用的旧版本和当前最新版本下,用排序选择和轮盘赌选择各运行若干次,记录每代被选为父代的个体在种群中的适应度排名,再比较最终最优解。如果新版本中排名靠前的个体被选中的频率明显上升,说明旧实验受到了选择偏差的影响,正式实验值得重跑。
参考文献
-
Ahmed Fawzy Gad 等. ahmedfgad/GeneticAlgorithmPython:GitHub 仓库及 LICENSE(BSD-3-Clause),2026-10-21 访问。
-
PyGAD 3.8.0 发布说明,2026-10-09。
-
PyGAD 3.8.1 发布说明,2026-10-11。
-
PyGAD 3.9.0、3.9.1、3.9.2 发布说明,2026-10-16。
-
PyGAD 官方文档,2026-10-21 访问。
-
PyGAD pyproject.toml,2026-10-21 访问。
-
Gad A F. PyGAD: an intuitive genetic algorithm Python library. Multimedia Tools and Applications, 83: 58029–58042(2023-12-19 在线发表). doi:10.1007/s11042-023-17167-y
-
信息由 Scholay 学术一站式平台 整理并发表,如有侵权请反馈下架。
-
信息同步发表于恩特学术,智能时代的学者社区
在交互式日历中查看这条记录 ↗