学术资源 / 固定快照
Ray 2.59 新增基于磁盘的外部 Shuffle
Ray 是 ray-project/ray 仓库维护的开源分布式计算框架,可把 Python 写的数据处理、训练与推理任务扩展到多核和集群,主体代码采用 Apache 2.0 许可证。2026 年 10 月 2 日发布的 2.59.0 为 Ray Data 加入基于磁盘的外部 Shuffle,并将 Ray Data LLM 与 Ray Serve LLM 定为正式可用。本文为资料核验,未安装实测。  数据中心网络核心区。摄影:Roy Niswanger(motleypixel),来源:[Flickr](https://www.flickr.com/photos/16894864@N05/6239564720),许可:[CC BY 2.0](https://creativecommons.org/licenses/by/2.0/)。 仓库自述把 Ray 称为“AI 计算引擎”,由核心分布式运行时和一组 AI 库组成。核心运行时负责在多台机器之间调度任务,并把数据块存放在共享内存对象存储中;上层库各管一段流程:Ray Data 读取和转换数据集,Ray Train 做分布式训练,Ray Serve 部署模型服务,RLlib 用于强化学习。项目官网为 ray.io,仓库创建于 2016 年,截至 2026 年 10 月 21 日未归档,仍有持续提交。许可证方面,GitHub 识别为 Apache-2.0;LICENSE 正文在 Apache 2.0 条款之后,还列出了改编自其他项目、沿用原许可(如 MIT)的部分代码。 ### 2.59.0 的主要变化 GitHub Release 页面显示,Ray 2.59.0 于 2026 年 10 月 2 日发布。对数据处理用户最重要的是 Ray Data 的外部 Shuffle:新的 Shuffle 后端 shuffle_v2 增加了基于磁盘的外部模式,配套新增运行时库、任务与算子以及执行计划接入,Join 与聚合也可以运行在外部 Shuffle 上。Shuffle 指按键把各数据块中的行重新分配到不同分区,Join、GroupBy 和按键重分区都依赖这一步。官方文档说明,shuffle_v2 不再把中间数据长期放在聚合 Actor 的内存里,而是放进对象存储,内存紧张时可以溢写到磁盘。同一版本把策略名从 hash_shuffle_v2 改为 shuffle_v2,压缩参数从 hash_shuffle_compression 改为 shuffle_compression,沿用旧名称的脚本需要相应修改。 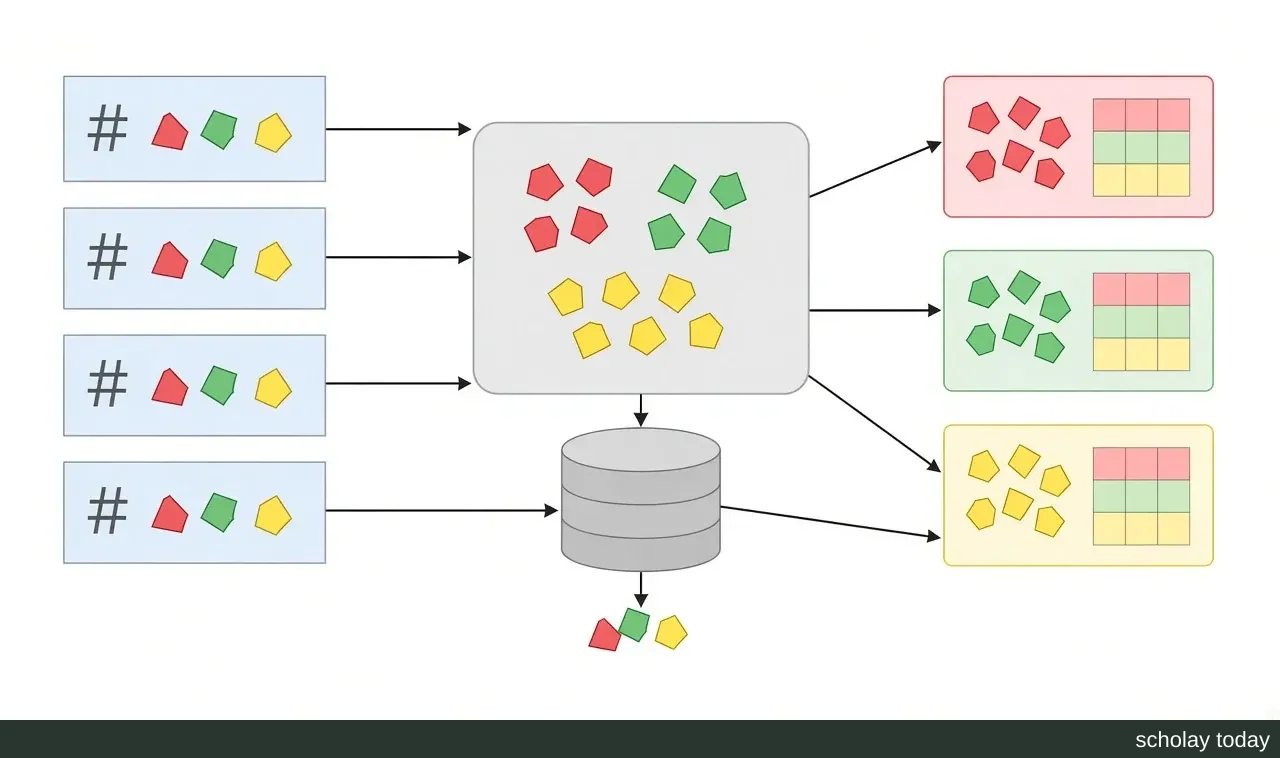 外部 Shuffle 结构示意:输入块按键拆分到各分区,对象存储内存不足时将分片溢写到磁盘,归并阶段从内存和磁盘读回同一分区的分片并输出结果。AI 生成示意图,依据 Ray 2.59.0 发布说明与 Ray Data internals 文档绘制。 其他变化集中在四个方面。一是大语言模型接口:Ray Data LLM 与 Ray Serve LLM 转为正式可用(GA),并升级到 vLLM 0.27.0。二是数据源:新增 ORC 文件读取,read_lance 可一次读取多个路径,read_videos 增加帧率与尺寸参数;Iceberg 读取改进了解码大小估计和读任务内存上限,并修复了 count() 返回错误行数的问题。三是安全:不带地址调用 ray.init() 启动的本地集群默认开启令牌认证,令牌不存在时自动生成在 ~/.ray/auth_token,远程和多节点集群在本版不变,可设置 RAY_AUTH_MODE=disabled 关闭;仪表盘会隐藏 runtime_env 中可能含有凭据的值,read_hudi 增加了防止远程代码执行的反序列化保护。四是后续预告:Ray 2.61 将把令牌认证扩展到所有集群,2.59.0 也是最后一个发布 CUDA 11.7 镜像的版本。截至 10 月 21 日,Releases 页面上 2.59.0 仍是最新的次版本,当天另有 2.58.1 和 2.57.1 两个旧分支补丁。
- 收录日期
- 2026-10-21
- 类别
- 基础设施
- 状态
- 资料核验,未安装实测(核验日 2026-10-21)
为何收录
对科研用户,Ray 主要用在数据规模超出单机内存、但仍希望用 Python 组织流程的场合。例如把样本元数据表与大型测量矩阵按样本编号连接,按实验条件汇总多年的仪器日志,或对多模态语料做批量清洗,这些步骤的瓶颈常在 Join 与 GroupBy 产生的中间数据。2.59.0 的外部 Shuffle 针对的正是这一环节:中间分片可以落到磁盘,不必整块留在内存中,适合内存有限、本地磁盘较充足的课题组服务器或小型集群。Ray Data LLM 转为正式可用,便于在同一条数据管线里对大批文本(如论文摘要)批量调用大语言模型做标注或信息抽取。本地集群默认启用令牌认证,也降低了共用实验室服务器上集群在无认证状态下运行的风险。
准备试用的团队可以先做一次小规模验收(建议,本文未执行):取一份单机内存能处理的数据子集,分别用默认策略和 ShuffleStrategy.SHUFFLE_V2 完成同一个 Join 或 GroupBy,核对两次结果的行数和汇总值是否一致,再记录峰值内存、溢写量和耗时;确认无误后再逐步放大数据量。
局限与注意事项
第一,成熟度有限。当前文档仍把 shuffle_v2 标为 alpha,按键操作的默认策略仍是 HASH_SHUFFLE,需要通过 DataContext 的 shuffle_strategy 或环境变量 RAY_DATA_DEFAULT_SHUFFLE_STRATEGY 主动启用;Join 功能本身也标注为实验性。本文查阅的文档页没有单独说明外部磁盘模式的开关,使用前应查对应版本的 API 文档。第二,覆盖范围有限:shuffle_v2 目前支持聚合、GroupBy、按键重分区和 Join,不支持 sort 与 random_shuffle。第三,落盘不等于没有资源上限。文档提醒,溢写会明显拖慢执行,排队数据过多还可能把磁盘写满;Shuffle 产生大量小分片时,头节点可能内存不足,可把 RAY_max_direct_call_object_size 调低(例如 8192 字节)。Join 的分区数也要权衡,分区过大仍会内存溢出,过小则额外开销增加。第四,升级可能影响现有脚本:本地集群已默认启用令牌认证,2.61 起将覆盖所有集群,远程或多节点连接需要提前分发同一令牌。第五,许可证要分开核对:Ray 主体为 Apache 2.0,部分第三方代码沿用原许可,vLLM 等依赖和通过 LLM 接口加载的模型权重各有条款。本文为资料核验,未安装实测,不含任何实测性能数据。
参考文献
-
ray-project. ray-project/ray GitHub 仓库(核验于 2026-10-21)
-
ray-project. Ray-2.59.0 Release,2026-10-02
-
ray-project. Releases · ray-project/ray(核验于 2026-10-21)
-
ray-project. Ray LICENSE
-
Ray Docs. Ray Data internals
-
Ray Docs. Joining data
-
Ray Docs. Advanced: Performance Tips and Tuning
-
信息由 Scholay 学术一站式平台 整理并发表,如有侵权请反馈下架。
-
信息同步发表于恩特学术,智能时代的学者社区
在交互式日历中查看这条记录 ↗